 HueWalls
MOSS-Image 在 Mac 上的 ComfyUI 实测:从报错到出图
MOSS-Image 在 M4 Max Mac 上用 ComfyUI 跑通的记录:能用的三个模型文件、w4a8 编码器和 er_sde 采样器各踩的一个坑、精简的工作流 JSON,以及手机竖版约 8.5 分钟一张的实测耗时。
MOSS-Image 是 2026 年 10 月 16 日发布的开源文生图模型(5B 参数的 DiT,搭配 Qwen3.5 文本编码器和 FLUX.2 的 VAE,模型页标注为 Apache 2.0)。我们想知道它能不能在一台 Mac 上跑起来,用来做 HueWalls 的壁纸。
结论:能跑,但不能照着官方工作流直接点运行。 要换一个文本编码器、关掉提示词扩写、把采样器从 er_sde 换成 euler。这样在 M4 Max 上,928×2016 的手机竖版 25 步约 8.5 分钟出一张。下面按我们实际走过的顺序记录;所有数字都来自我们自己的机器,只跑过一次或没测过的地方会直接说明。
最后能跑的组合
| 项目 | 版本 |
|---|---|
| 机器 | Mac,M4 Max,64 GB 统一内存 |
| 系统 | macOS 15.3 |
| ComfyUI | 0.42.5(已经内置 MOSS 的节点,不用升级) |
| Python / PyTorch | 3.13.12 / 2.12.1(MPS) |
三个模型文件,来自 Hugging Face 的 Comfy-Org/MOSS-Image 仓库(ComfyUI 用的拆分权重):
| 文件 | 放在 | 大小 | 说明 |
|---|---|---|---|
moss_image_sft_int8_convrot.safetensors |
models/diffusion_models/ |
5.04 GiB | 主模型 |
qwen3.5_9b_int8_convrot.safetensors |
models/text_encoders/ |
9.08 GiB | 文本编码器,Mac 上要用这个版本 |
flux2-vae_small.safetensors |
models/vae/ |
0.23 GiB | VAE(换成完整版 flux2-vae 结果一样) |
CLIPLoader 的 type 选 moss_image。采样设置:25 步,CFG 2.5,采样器 euler,调度器 simple。官方模板默认的是 er_sde,原因在后面。
第一个坑:官方工作流里的 w4a8 编码器
官方工作流默认用 qwen3.5_9b_w4a8_gptq(6.84 GiB)做文本编码器,而且默认打开提示词扩写:用同一个 Qwen3.5 当语言模型,把你写的短提示词扩写成长的英文描述,再拿去出图。这条路在 Mac 上走不通,我们试了两种放法:
- 放 CPU(ComfyUI 的默认)。 我们读了
comfy/model_management.py里决定文本编码器设备的函数:不加--gpu-only时,Mac 的 MPS 上相关判断通常不通过,编码器就落到 CPU。CPU 能跑,但极慢。我们在同类的 w4a8 编码器(FLUX 3 的提示词扩写模型)上量过:生成 19 个 token 用了 4 分 26 秒,每个 token 13 到 16 秒,上限 3584 个 token,预计要 13 个小时以上。MOSS 的 w4a8 编码器是同一种量化,但我们没有单独把扩写跑完。 - 放 GPU(加
--gpu-only)。 直接报错,3.6 秒就失败:Trying to convert Float8_e4m3fn to the MPS backend but it does not have support for that dtype。失败的是负面提示词那个普通的 CLIPTextEncode 节点,所以光关掉扩写开关也没用,只要编码器在 GPU 上就报。我们的判断是:w4a8 解压权重要用 float8 的缩放系数,而 MPS 不支持 float8。这是推断,没有去读量化代码验证。
解决办法: 官方仓库里还有一份 qwen3.5_9b_int8_convrot,同一个 Qwen3.5 9B,只是换成 int8 格式(和我们本地 Qwen 流程用的是同一种量化)。它在 MPS 上正常加载、正常运行。同时我们把提示词扩写关掉,直接用自己写的英文提示词。现在我们的启动参数里没有 --gpu-only。
代价是没有了扩写:官方工作流内置的系统提示词要求把短提示词展开成 220 到 320 词的长描述(单主体场景),关掉之后提示词要自己写细。没有扩写会让画质损失多少,我们没有验证。
第二个坑:25 步全黑,凶手是采样器
换成 int8 编码器之后,第一张图跑完 25 步,是一张纯黑的图。我们一项项排除:
| 测试 | 结果 |
|---|---|
| 文本编码器的输出 | 正常,没有 NaN(排除 fp16 溢出) |
| 换成完整版 VAE | 还是全黑(排除 VAE) |
er_sde,2 步 |
有图,但非常糊 |
er_sde,6 步 |
正常,出了完整的图 |
er_sde,25 步 |
全黑 |
euler,25 步 |
正常,像素范围 0 到 255,均值 66,用时 267 秒 |
结论:在我们这台 Mac(MPS)上,er_sde 步数多了会出数值错误,最后输出全黑,euler 没有这个问题。解决只需要把工作流里的采样器改成 euler,不用动启动参数。我们没有去查 er_sde 内部的原因,也没有在别的机器上复现,所以这条只能说“在这台机器上”。
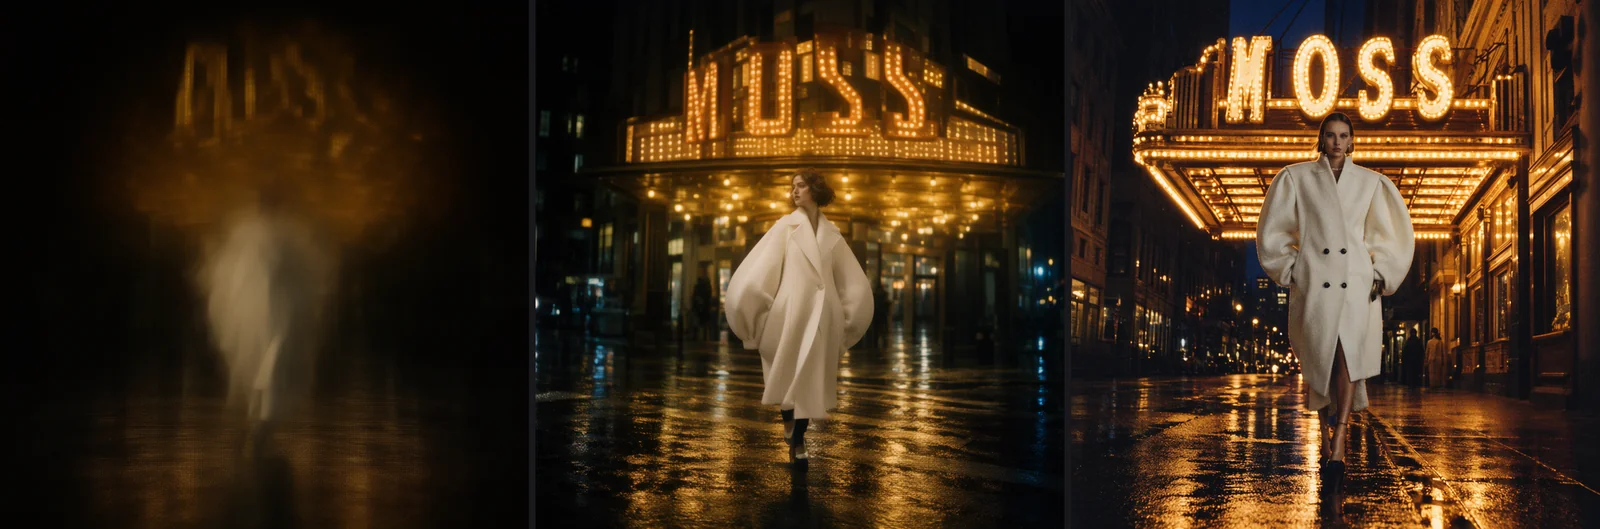
同一个提示词、同一个种子(452138030585152)。左、中是 er_sde 的 2 步和 6 步,右是 euler 的 25 步。
最终的工作流
下面是精简后的 API 格式工作流:去掉了提示词扩写和跳过层引导,只剩加载、编码、采样、解码、保存。保存成 moss_api.json,就能直接提交给本机的 ComfyUI。写这篇文章时,我们又用它在 928×2016 上跑了一遍 6 步,确认能出图(160 秒)。
{
  "9": {
    "class_type": "SaveImage",
    "inputs": {
      "filename_prefix": "moss",
      "images": [
        "8",
        0
      ]
    }
  },
  "1": {
    "class_type": "UNETLoader",
    "inputs": {
      "unet_name": "moss_image_sft_int8_convrot.safetensors",
      "weight_dtype": "default"
    }
  },
  "2": {
    "class_type": "CLIPLoader",
    "inputs": {
      "clip_name": "qwen3.5_9b_int8_convrot.safetensors",
      "type": "moss_image",
      "device": "default"
    }
  },
  "3": {
    "class_type": "VAELoader",
    "inputs": {
      "vae_name": "flux2-vae_small.safetensors"
    }
  },
  "4": {
    "class_type": "CLIPTextEncode",
    "inputs": {
      "text": "",
      "clip": [
        "2",
        0
      ]
    }
  },
  "5": {
    "class_type": "CLIPTextEncode",
    "inputs": {
      "text": "nsfw, worst quality, bad anatomy, watermark, jpeg artifact",
      "clip": [
        "2",
        0
      ]
    }
  },
  "6": {
    "class_type": "EmptyFlux2LatentImage",
    "inputs": {
      "width": 928,
      "height": 2016,
      "batch_size": 1
    }
  },
  "7": {
    "class_type": "KSampler",
    "inputs": {
      "seed": 1,
      "steps": 25,
      "cfg": 2.5,
      "sampler_name": "euler",
      "scheduler": "simple",
      "denoise": 1.0,
      "model": [
        "1",
        0
      ],
      "positive": [
        "4",
        0
      ],
      "negative": [
        "5",
        0
      ],
      "latent_image": [
        "6",
        0
      ]
    }
  },
  "8": {
    "class_type": "VAEDecode",
    "inputs": {
      "samples": [
        "7",
        0
      ],
      "vae": [
        "3",
        0
      ]
    }
  }
}
提交脚本只需要改几个字段(节点 4 是提示词,6 是尺寸,7 是种子和步数,9 是文件名前缀):
import json, random, time, urllib.request

HOST = "http://127.0.0.1:8188"

def call(path, body=None):
    req = urllib.request.Request(HOST + path, data=json.dumps(body).encode() if body is not None else None,
                                 headers={"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req, timeout=30))

wf = json.load(open("moss_api.json"))
wf["4"]["inputs"]["text"] = "A rainy night in a narrow city alley lit by pink and blue neon, ..."  # positive prompt
wf["6"]["inputs"].update(width=928, height=2016)                       # multiples of 16
wf["7"]["inputs"].update(seed=random.randint(1, 2**50), steps=25)      # keep sampler_name = euler
wf["9"]["inputs"]["filename_prefix"] = "moss_demo"

pid = call("/prompt", {"prompt": wf, "client_id": "demo"})["prompt_id"]
while pid not in (hist := call("/history")):
    time.sleep(10)
print(hist[pid]["status"]["status_str"], [i["filename"] for o in hist[pid]["outputs"].values() for i in o.get("images", [])])
我们用过的尺寸,宽高都是 16 的倍数:1024×1024、928×2016、1600×896,别的尺寸没试。
实际速度
| 尺寸 | 步数 | 采样器 | 提交到出图 | 说明 |
|---|---|---|---|---|
| 1024×1024 | 25 | euler |
267 秒 | 一次 |
| 1024×1024 | 6 | er_sde |
约 66 秒 | 一次 |
| 928×2016 | 25 | euler |
513 秒(约 8.6 分钟) | 手机竖版,一次 |
| 928×2016 | 6 | euler |
160 秒 | 验证工作流,一次 |
| 1600×896 | 25 | euler |
370 秒 | 本文封面,一次 |
每一项都只跑了一次,没有取平均,所以只能当作量级参考。和我们另一篇记录的 FLUX 3 Klein 相比(手机尺寸 30 步约 9 到 10 分钟,见在 Mac 上用 ComfyUI 跑 FLUX 3 Klein),速度在同一个量级。
出图效果:文字稳,人物不稳
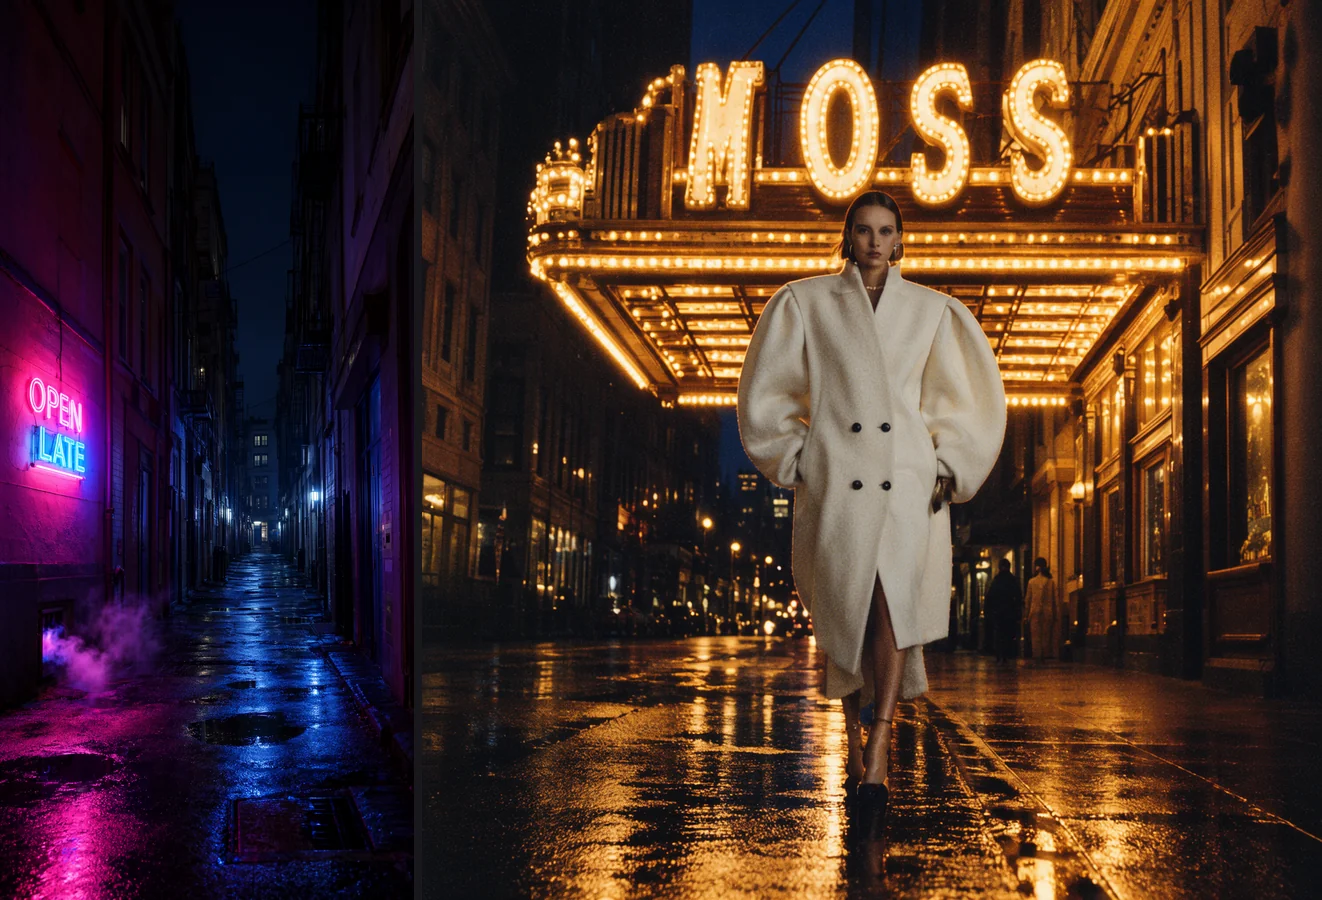
左:928×2016,25 步,提示词见下。右:1024×1024,25 步,种子 452138030585152。
我们看下来的感受:
- 文字很稳。 25 步时,小巷里的
OPEN LATE和剧院灯牌上的MOSS都拼对了。6 步就不行了:在 928×2016 上跑 6 步时,OPEN LATE出现了两遍,右侧的一个还残缺。 - 场景和光线不错。 粉蓝霓虹在湿地面上的倒影、暖色灯泡的胶片感都很好,上方留出了干净的夜空,适合放手机锁屏时钟。
- 整体偏暗,纹理偏糊。 小巷左侧的墙面细节不够。作为手机壁纸,暗调在 OLED 屏上不算缺点,但看细节会觉得平。
- 人物的肢体不稳。 右图的模特上半身和脸没问题,小腿偏细,鞋和大衣下摆的结构不对。所以我们打算只用 MOSS 出没有人的场景。
- 和官方 Space 比,我们的主观印象是本机版更暗、更平。 我们对照过官方 Space 上出的图(提示词基本相同,Space 那条多了几句“避免……”)。我们调用 Space 时用的是 50 步、CFG 3、跳过层设为第 22 层;本机是 25 步、CFG 2.5、没有跳过层、用的是 int8 量化。差在哪一项,我们没有验证。
小巷这张的提示词(约 70 个词,没有扩写):
A rainy night in a narrow city alley lit by pink and blue neon, a glowing neon sign on the lower half of the wall with the words OPEN LATE, wet asphalt reflecting the colourful lights, steam rising from a small vent, a few puddles, cinematic and moody, ultra detailed, the upper third a calm dark night sky between the buildings.
我们没验证的
- 提示词扩写。 int8 编码器能不能在 MPS 上跑扩写、效果怎样,没试。
- 画质差距的原因。 50 步、CFG 3、跳过层引导各自有多大影响,没做对照实验。
- bf16 版本。 主模型(
moss_image_sft_bf16)和编码器的 bf16 版本都没下载。 - 尺寸上限。 我们最大只跑到 928×2016,更大的尺寸不知道会不会像 FLUX 3 那样报错。
- 内存占用、批量出图、别的采样器。 都没测。
- 商用条款。 模型页写的是 Apache 2.0,细节请自己核对原文。
如果你想在 Mac 上找一个文字渲染可靠、能放进批量流程的文生图模型,MOSS 可以用,但要有耐心:一张手机图要八九分钟,而且最好只让它画场景。