 HueWalls
MiniMax H3-Image 实测:4K 一张 64 秒,4MP 只要 13 秒
在 Hugging Face 上实测 MiniMax H3-Image:16:9 的 16MP 出图 64 秒、4MP 只要 13 秒;HF 通用推理 API 不支持这个模型,免费配额一天只够一张 4K。
MiniMax 在 11 月 10 日晚发布了 H3-Image 并同步开放权重。官方口径是"4K、10 秒、开源"。我们更关心一个窄一点的问题:这东西能不能拿来批量出壁纸,以及在 Hugging Face 上调用它,实际要付多少时间成本。
下面是一轮从本机发起的实测记录,包含三档规格的真实输出尺寸、耗时,以及一个很容易踩到的配额坑。本文不评价画质——出图没有逐张核看,只报告能复现的数字。
测试环境
| 项目 | 配置 |
|---|---|
| 机器 | Mac(本机只负责调用,模型跑在远端) |
| Python | 3.13.12 |
| 客户端 | gradio_client 2.7.2 |
| 调用入口 | Hugging Face Space MiniMaxAI/minimax-h3-image(zero-a10g) |
| 账号 | Hugging Face 免费账号 |
| 固定参数 | seed=42、enhance=False、reasoning_effort=low |
为什么走 Space 而不是 HF 推理 API
Hugging Face 确实有通用推理接口,但这个模型不在里面。查模型元数据,inferenceProviderMapping 返回的是空对象;直接打 router 会得到:
HTTP 400
{"error":"Model not supported by provider hf-inference"}
作为对照,同一个查询在 FLUX.1-schnell 上会列出 fal-ai、wavespeed、deepinfra 三家 provider。H3-Image 是 331B 参数的稠密 DiT,BF16 权重 68.65 GB,没有 provider 愿意为它挂常驻实例,所以官方选择用 Gradio Space 提供免费体验入口。
Space 只暴露了一个端点 /generate,参数不多,直接调就能出图:
from gradio_client import Client

client = Client(
    "MiniMaxAI/minimax-h3-image",
    token=open("/path/to/hf_key").read().strip(),
)
image_path, seed, prompt = client.predict(
    prompt="a quiet alpine lake at blue hour",
    images=[],
    aspect="16:9",
    resolution="16 MP",
    seed=42,
    randomize=False,
    enhance=False,
    reasoning_effort="low",
    api_name="/generate",
)
一个细节:新版 gradio_client 的构造参数是 token,不是老示例里的 hf_token,写错会直接 TypeError,请求都发不出去。
结果
同一套参数,每档各出一张:
| 参数 | 实际输出 | 文件体积 | 生成耗时 |
|---|---|---|---|
| 16:9 / 16 MP | 5472×3072(16.81 MP) | 21.7 MB | 63.9 秒 |
| 9:16 / 4 MP | 1536×2720(4.18 MP) | 7.0 MB | 18.2 秒 |
| 16:9 / 4 MP | 2720×1536(4.18 MP) | 4.5 MB | 12.8 秒 |
端到端还要加 4~9 秒的连接时间,这部分取决于 Space 当时是否在队列里。
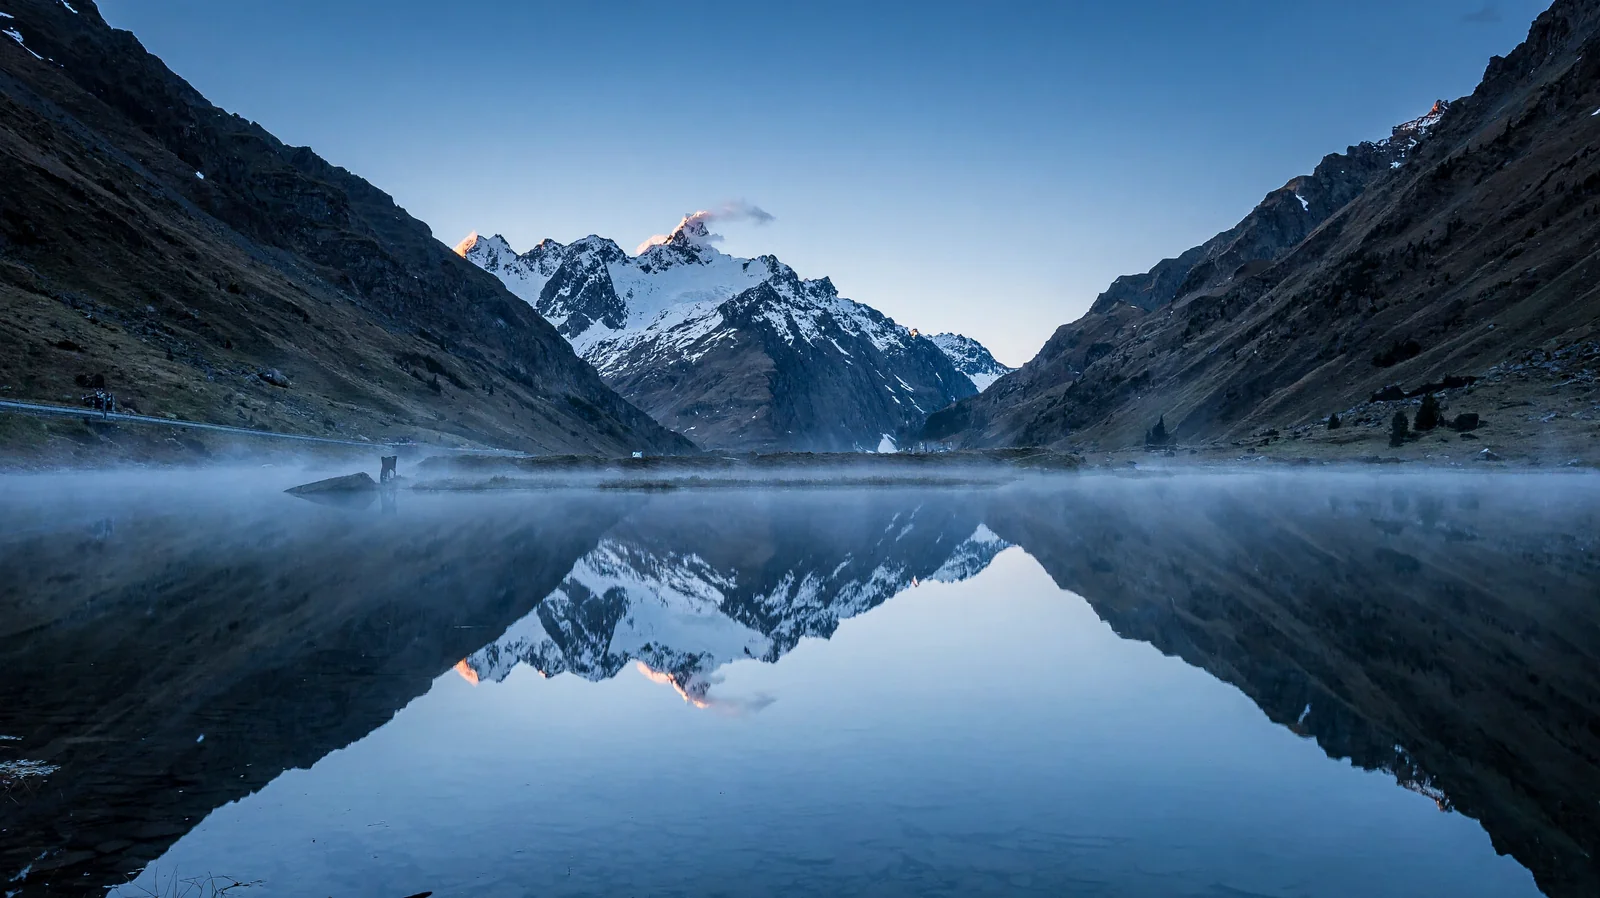
16:9 / 16 MP:5472×3072,21.7 MB,生成 63.9 秒
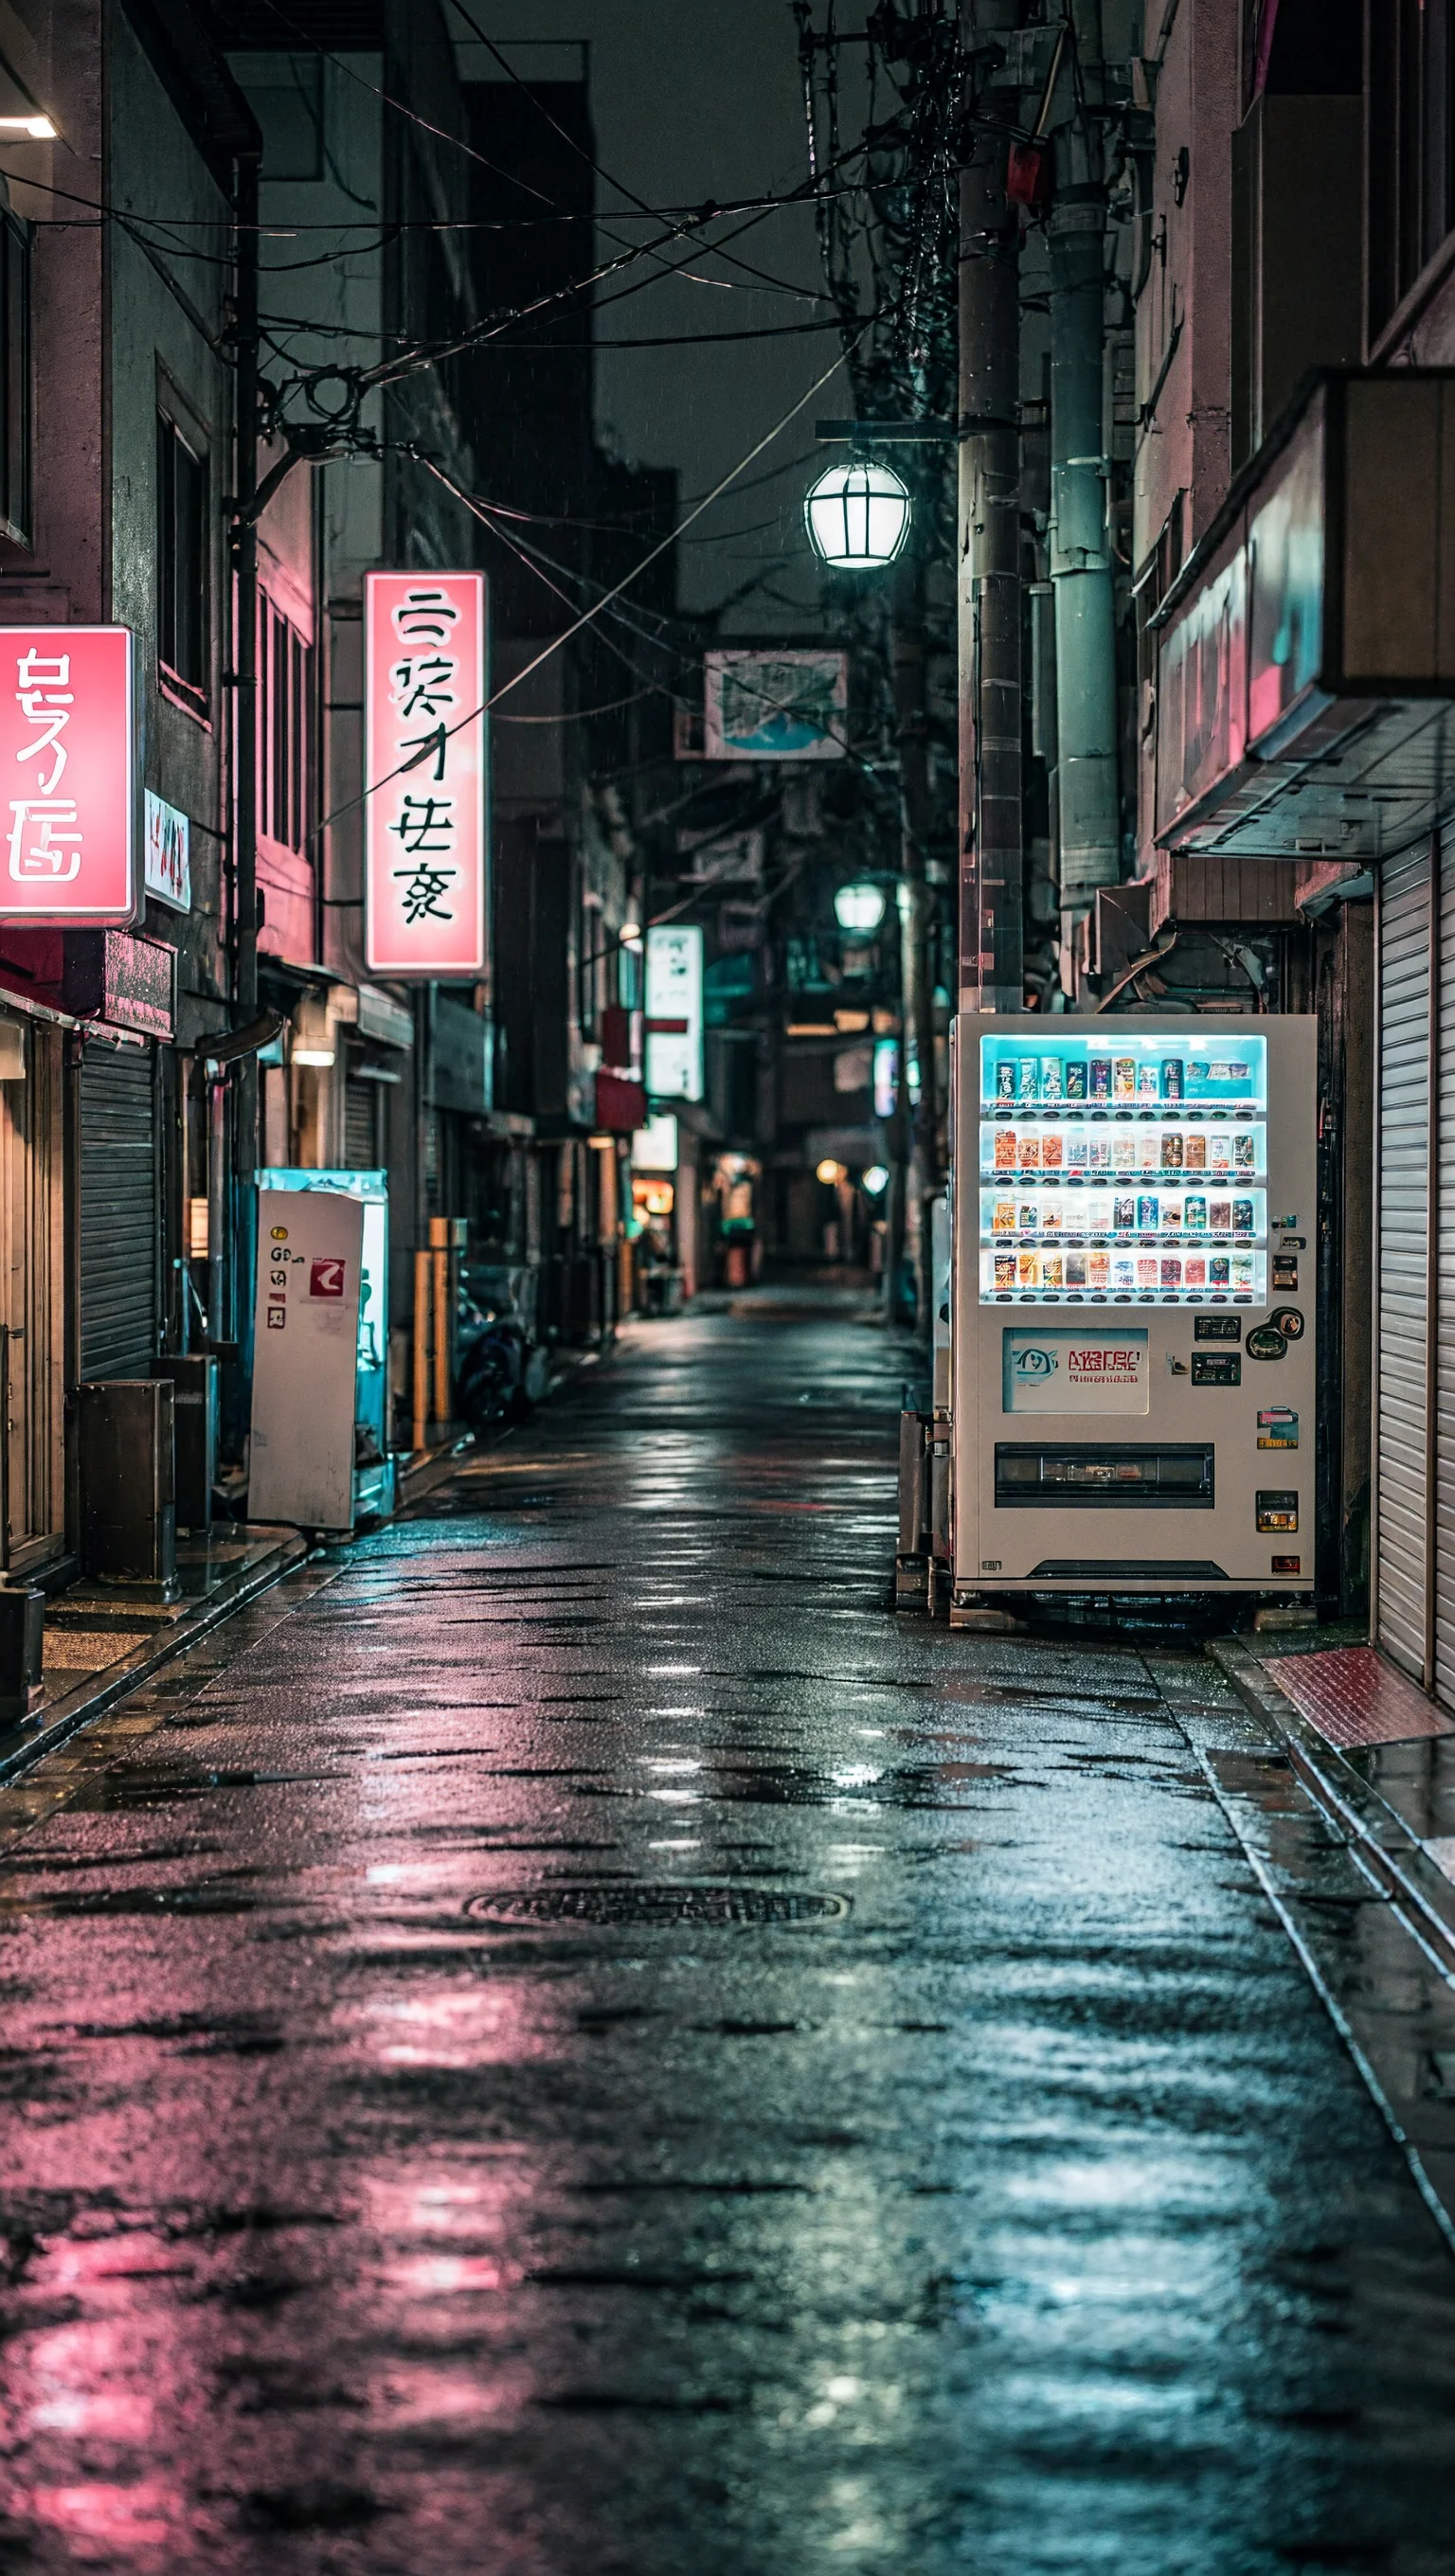
9:16 / 4 MP:1536×2720,7.0 MB,生成 18.2 秒
几个能直接用的结论:
- 耗时基本跟总像素走,和长宽比关系不大。同为 4.18 MP,竖版 18.2 秒、横版 12.8 秒,差的这几秒更像排队波动,不像长宽比带来的系统差异。
- 16 MP 大约是 4 MP 的 4~5 倍时间,比线性略好一点,但量级就是这样。
- 输出尺寸可预期,都是 16 的倍数,和官方给的档位对得上,不需要再超分。
官方 P50 报的是 16 秒(Highspeed 模式 10.3 秒),我们这边 64 秒。这个差距更可能来自 ZeroGPU 共享实例和排队,而不是模型本身的单卡耗时——不过我们没在独占卡上验证,这一点只能存疑。
免费额度的坑
这是这轮测试里唯一真正卡住流程的地方。
第二张图(9:16 / 16 MP)直接失败:
AppError: You have exceeded your free ZeroGPU quota
(278s requested vs. 61s left). Try again in 23:58:35.
关键在括号里那句。ZeroGPU 按申请时长扣配额,不是按实际生成时长。一次 16 MP 请求占 278 秒,免费账号每天约 300 秒,所以一天只能出一张 16 MP。第一张图实际只跑了 63.9 秒,账上照样扣掉 278 秒。
4 MP 一张约 70 秒,同样的额度一天能出 3~4 张。要更多只能上 HF PRO(官方写的是 40 分钟/天),或者改用 MiniMax 开放平台的付费 API。
对壁纸选型的结论
按实测尺寸和耗时,壁纸站可以这样分配档位:
| 用途 | 建议规格 | 理由 |
|---|---|---|
| 手机壁纸 | 4 MP 竖版(1536×2720) | 覆盖 1080×2340 有余,单张 18 秒 |
| PC 2K 桌面 | 4 MP 横版(2720×1536) | 大于 2560×1440,单张 13 秒 |
| 4K 桌面专题 | 16 MP 横版(5472×3072) | 只有这一档够 4K,单张 64 秒且吃满一天额度 |
日常批量走 4 MP,时间成本是 16 MP 的四分之一到五分之一,配额也能多用三倍;16 MP 留给必须 4K 的专题。这个结论只基于尺寸和耗时,画质是否够还没有结论。
还没测的
- 画质:三张图都出了,但没有做主观评分,也没做同提示词 4 MP / 16 MP 的放大对比,本文不给画质结论。
- 稳定性:每个规格只跑了 1 张、固定 seed,重复性和多样性都没验证。
- 价格:媒体报的 4K 文生图 ¥0.2261/张来自发布报道,不是我们自己调付费 API 测出来的账。
- 并发:免费额度下测不了并发,排队行为也没有记录。
小结
- H3-Image 能在 Hugging Face 上跑,但只能走官方 Space 的 Gradio 接口,通用推理 API 不支持它。
- 16:9 / 16 MP 实测 64 秒出图,4 MP 只要 13~18 秒。
- 免费额度按申请时长扣,一张 16 MP 就吃掉一天的量。
- 壁纸站日常用 4 MP 更划算,16 MP 只留给 4K 桌面专题。