 HueWalls
MacでMOSS-Imageが真っ黒になる原因切り分け|25ステップ黒画像の対処
M4 MaxのComfyUIでMOSS-Imageを動かすと、25ステップで完全な黒画像が出ることがあります。w4a8エンコーダとer_sdeサンプラーという二つの罠を対照試験で切り分け、int8+eulerの設定、実測時間、作例の弱点まで整理しました。
Mac(MPS)で MOSS-Image を試し、int8 のテキストエンコーダに差し替えてようやく生成が走ったところ、出てきたのは完全な黒い画像でした。ステップ数は 25。設定を戻して 6 ステップにすると普通に絵が出る——この症状は、モデルの読み込み失敗ではなくサンプラー側の問題です。
MOSS-Image は 2026年10月16日公開のオープンソース text-to-image モデルで、5B パラメータの DiT、テキストエンコーダは Qwen3.5 系、VAE は FLUX.2 VAE を使います。構成自体は素直ですが、公式ワークフローをそのまま Mac に載せると別の場所で止まります。この記事では、まず「どこが悪いのか」を切り分ける手順と対照試験の結果を示し、そのうえで動いた設定、実測の待ち時間、作例から読める得意・不得意をまとめます。
まず切り分け:黒画像はエンコーダか、サンプラーか
黒画像や異常に遅い生成に出会ったら、次の順で確認するのが早いです。
- エラーログに
Float8_e4m3fnと MPS が出ていないか → w4a8 テキストエンコーダの問題です。サンプラーをいくら変えても直りません。 - エラーは出ないが極端に遅い → エンコーダが CPU に落ちています。プロンプト拡張が既定でオンになっている点も効いてきます。
- int8 エンコーダで動き、少ないステップなら絵が出るのに 25 ステップで黒くなる → サンプラー
er_sdeの問題です。eulerに変えます。 - 上記を直しても黒い → 今回は VAE と fp16 オーバーフローを対照試験で除外済みなので、別の要因を疑う段階です。
罠1:w4a8 エンコーダは MPS で通らない
公式ワークフローが指定するのは qwen3.5_9b_w4a8_gptq(6.84 GiB)です。起動引数に --gpu-only を付けた場合は 3.6 秒で即座に失敗し、エラーは「Trying to convert Float8_e4m3fn to the MPS backend but it does not have support for that dtype」。落ちたのはネガティブプロンプト側の素の CLIPTextEncode ノードでした。つまりプロンプト拡張をオフにしても解決せず、w4a8 エンコーダを GPU に載せる経路そのものが通りません。重みを展開するのに float8 のスケール係数が要るため、という推測は立ちますが、量子化コードを読んで確認したわけではないので、ここでは推測どまりとして扱います。
--gpu-only を外すと挙動は変わります。comfy/model_management.py のデバイス選択で MPS では判定が通らず、エンコーダは CPU に落ちます。動くには動くのですが、非常に遅くなります。参考値として、同じ w4a8 系の別エンコーダ(FLUX 3 のプロンプトアップサンプラー。MOSS 本体のエンコーダではありません)で 19 トークンの処理に 4 分 26 秒、1 トークンあたり 13〜16 秒でした。上限 3584 トークンまで回せば 13 時間を大きく超える計算になります。なお MOSS の w4a8 でプロンプト拡張を最後まで走らせた事実はなく、これは外挿値です。
プロンプト拡張は既定でオンで、同じ Qwen3.5 が言語モデルとしても働き、短い指示を単一被写体のシーン向け 220〜320 語の英語描写に書き換えます。Mac ではここが重い処理の入口になりやすい、という理解で十分です。
罠2:er_sde はステップを増やすと黒くなる
エンコーダを int8 版に替えて最初に遭遇したのが黒画像でした。原因を絞るために、条件を一つずつ変えて確認しています。
| 確認内容 | 結果 |
|---|---|
| テキストエンコーダの出力を検査 | 正常、NaN なし(fp16 オーバーフローを除外) |
| small ではなくフルサイズの FLUX.2 VAE | それでも黒(VAE を除外) |
| er_sde / 2 ステップ | 画像は出るが非常にぼやける |
| er_sde / 6 ステップ | 破綻のない完成画像 |
| er_sde / 25 ステップ | 完全な黒 |
| euler / 25 ステップ | 正常。ピクセル範囲 0–255、平均 66、267 秒 |
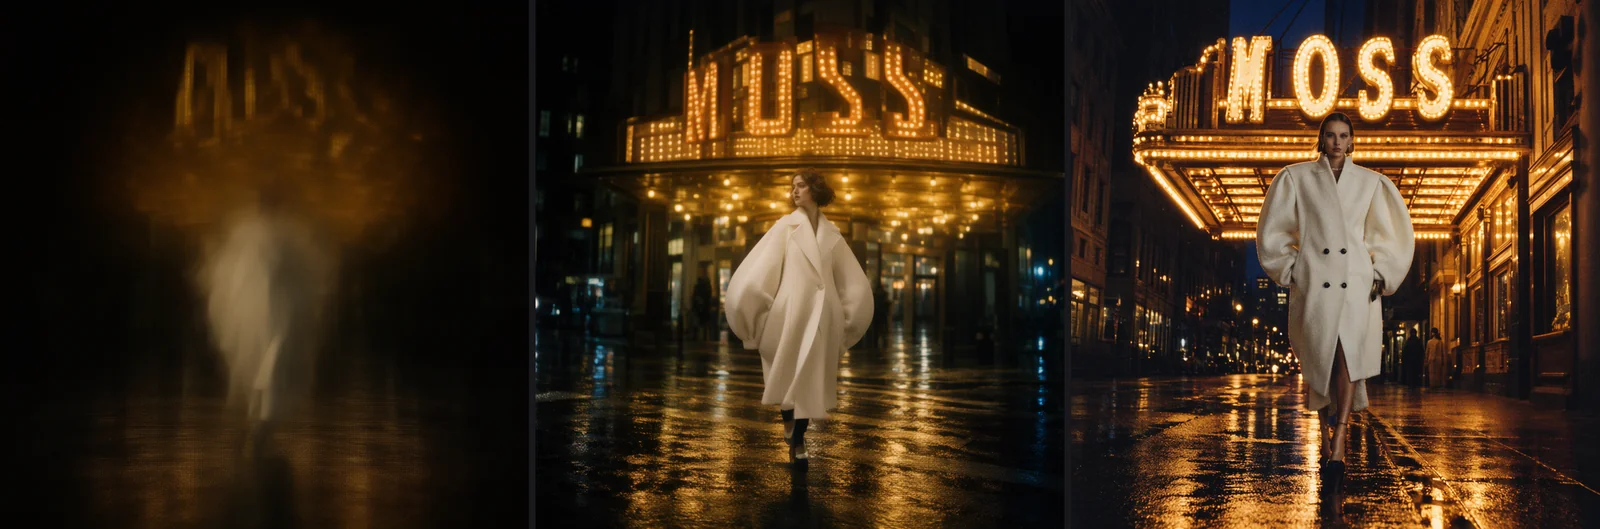 同一プロンプト・同一シード(452138030585152)。左と中央が er_sde の 2 ステップと 6 ステップ、右が euler の 25 ステップです。
この並びから言えるのは、「この Mac(MPS)では er_sde がステップ数を増やしたときに数値的な破綻を起こし、euler では起きない」ということです。修正はワークフローのサンプラー変更だけで、起動引数は関係しません。ただし er_sde が壊れる根本原因は調べておらず、他マシンでの再現もしていないため、「この環境では」という限定付きの結論として受け取ってください。
動いた構成:int8 convrot + euler
検証環境は M4 Max/64 GB ユニファイドメモリ、macOS 15.3、ComfyUI 0.42.5、Python 3.13.12、PyTorch 2.12.1(MPS)です。ComfyUI 0.42.5 には MOSS 用ノードがすでに組み込まれており、アップグレードは不要でした。分割重みは Hugging Face の Comfy-Org/MOSS-Image から取得します。
| ファイル | 配置先 | サイズ |
|---|---|---|
| moss_image_sft_int8_convrot.safetensors | models/diffusion_models/ | 5.04 GiB |
| qwen3.5_9b_int8_convrot.safetensors | models/text_encoders/ | 9.08 GiB |
| flux2-vae_small.safetensors | models/vae/ | 0.23 GiB |
テキストエンコーダは同じ Qwen3.5 9B の int8 convrot 版で、手元の Qwen ワークフローと同じ量子化方式です。これに替えると MPS で普通にロード・実行できました。CLIP ローダーの type は moss_image。VAE はフルサイズの flux2-vae でも結果は同じでした。あわせてプロンプト拡張をオフにし、英語プロンプトは手で書きます。拡張を失うことによる品質面の損失は測定していません。また int8 エンコーダで拡張が動くかどうか自体も未検証です。起動引数からは --gpu-only を外した状態が最終形です。
サンプリングは steps 25、CFG 2.5、sampler euler、scheduler simple。公式テンプレートの既定 er_sde からの変更点がここです。ワークフローは API 形式の JSON に整理し、プロンプト拡張と skip-layer guidance を削除して、ロード→エンコード→サンプル→デコード→保存の 5 段だけにしました。
実測の待ち時間と、作例が示すこと
投稿から画像が返るまでの時間です。すべて単発の実行で平均は取っておらず、桁感をつかむための数字として読んでください。
| サイズ | ステップ | サンプラー | 秒 | 備考 |
|---|---|---|---|---|
| 1024x1024 | 25 | euler | 267 | |
| 1024x1024 | 6 | er_sde | 約 66 | |
| 928x2016 | 25 | euler | 513 | スマホ縦向き、約 8.6 分 |
| 928x2016 | 6 | euler | 160 | ワークフロー確認 |
| 1600x896 | 25 | euler | 370 | 記事カバー画像 |
スマホサイズの壁紙 1 枚に 8〜9 分。Mac の ComfyUI で FLUX 3 Klein を動かした記事では同サイズ・30 ステップで 9〜10 分だったので、速度感は同じレンジです。バッチで流して放置する使い方なら現実的、対話的に何度も引き直す用途には向きません。
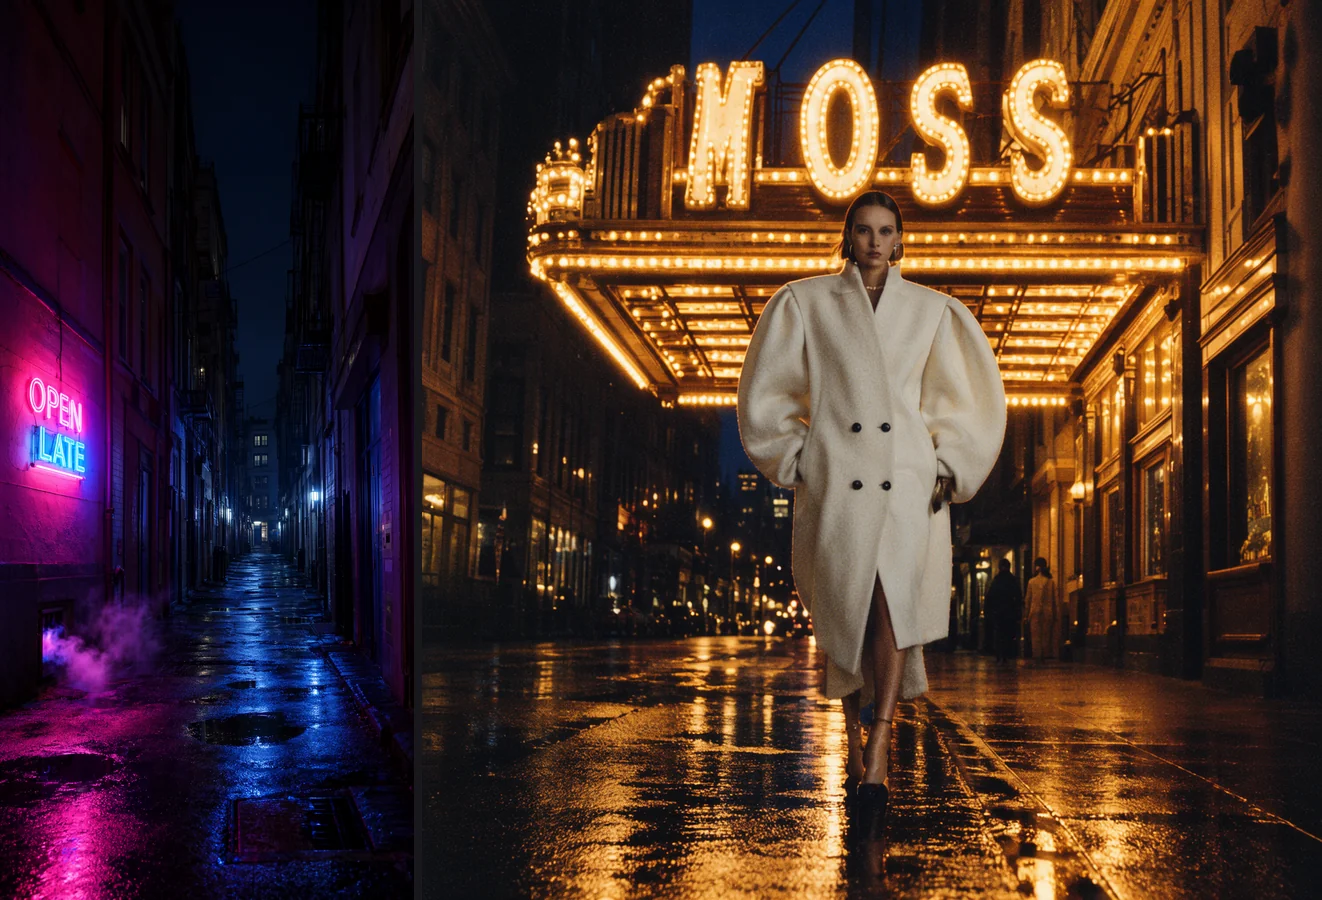 左は 928×2016・25 ステップ。右は 1024×1024・25 ステップ、シード 452138030585152 です。
作例から読める長所は文字です。25 ステップでは路地の「OPEN LATE」とマーキーの「MOSS」がどちらも正しい綴りで描画されました。一方 6 ステップでは崩れ、928x2016 の実行では「OPEN LATE」が 2 回現れ、2 つ目は途中で切れていました。文字を狙うなら 6 ステップは選択肢に入りません。
濡れた地面に映るピンクとブルーのネオン、フィルムのような暖色の電球はよく機能します。路地の構図は上部に clean な夜空が残り、スマホのロック画面の時計と干渉しにくいのも実用的です。反面、全体はやや暗めで質感が柔らかく、左の路地壁はディテールが不足しています。暗い階調は OLED のスマホでは問題になりにくいものの、拡大すると平坦に見えます。人物は顔と上半身は良好ですが、脚が細くなり、靴とコートの裾がまとまりません。このため HueWalls では人物を含まないシーンに限定して使う方針にしました。
公式 Space の出力と比べると、ローカルはやや暗く平坦に感じます。Space 側は steps 50/CFG 3/layer 22 の skip-layer、ローカルは steps 25/CFG 2.5/skip-layer なし/int8 量子化で、プロンプトもほぼ同じですが Space 側には「avoid …」系の文言が少し多く入っていました。差の原因は切り分けていないので、設定差・量子化・プロンプト差のどれが効いているかは不明です。
判断の目安と、検証していない範囲
結論として、Mac でも MOSS-Image は text-to-image として実用になります。条件是正は「w4a8 → int8 convrot」「プロンプト拡張オフ」「er_sde → euler」の 3 点だけ。文字描画が安定するので、看板やサインのある夜景をバッチで量産する用途に向いています。スマホ縦向きで 8〜9 分、人物は避ける——この前提で採用を判断してください。
試したのは 1024x1024、928x2016、1600x896 の 3 サイズで、いずれも幅・高さが 16 の倍数でした。それ以外のサイズは未検証です。928x2016 を超える大きさで FLUX 3 のようにエラーになるか、メモリ使用量、バッチ実行、er_sde と euler 以外のサンプラー、bf16 版(本体・エンコーダとも未取得)、er_sde 黒画像の根本原因と他ハードでの再現、プロンプト拡張を失う品質コストは、いずれも確認していません。ライセンスはモデルページに Apache 2.0 と記載されていますが、独立に検証はしておらず、商用判断の前に原文を自分で確認してください。
再現用に、整理した API 形式ワークフロー moss_api.json(ローカルの ComfyUI にそのまま投入できます)と投稿スクリプトを以下に載せます。スクリプトで編集するノードは 4 がプロンプト、6 がサイズ、7 がシードとステップ、9 がファイル名プレフィックスです。記事執筆中の動作確認は 928x2016・6 ステップで 160 秒でした。
再現用の設定と入力
以下は検証で使用した設定や入力です。実行環境と出力条件は本文を参照してください。
{
  "9": {
    "class_type": "SaveImage",
    "inputs": {
      "filename_prefix": "moss",
      "images": [
        "8",
        0
      ]
    }
  },
  "1": {
    "class_type": "UNETLoader",
    "inputs": {
      "unet_name": "moss_image_sft_int8_convrot.safetensors",
      "weight_dtype": "default"
    }
  },
  "2": {
    "class_type": "CLIPLoader",
    "inputs": {
      "clip_name": "qwen3.5_9b_int8_convrot.safetensors",
      "type": "moss_image",
      "device": "default"
    }
  },
  "3": {
    "class_type": "VAELoader",
    "inputs": {
      "vae_name": "flux2-vae_small.safetensors"
    }
  },
  "4": {
    "class_type": "CLIPTextEncode",
    "inputs": {
      "text": "",
      "clip": [
        "2",
        0
      ]
    }
  },
  "5": {
    "class_type": "CLIPTextEncode",
    "inputs": {
      "text": "nsfw, worst quality, bad anatomy, watermark, jpeg artifact",
      "clip": [
        "2",
        0
      ]
    }
  },
  "6": {
    "class_type": "EmptyFlux2LatentImage",
    "inputs": {
      "width": 928,
      "height": 2016,
      "batch_size": 1
    }
  },
  "7": {
    "class_type": "KSampler",
    "inputs": {
      "seed": 1,
      "steps": 25,
      "cfg": 2.5,
      "sampler_name": "euler",
      "scheduler": "simple",
      "denoise": 1.0,
      "model": [
        "1",
        0
      ],
      "positive": [
        "4",
        0
      ],
      "negative": [
        "5",
        0
      ],
      "latent_image": [
        "6",
        0
      ]
    }
  },
  "8": {
    "class_type": "VAEDecode",
    "inputs": {
      "samples": [
        "7",
        0
      ],
      "vae": [
        "3",
        0
      ]
    }
  }
}
import json, random, time, urllib.request

HOST = "http://127.0.0.1:8188"

def call(path, body=None):
    req = urllib.request.Request(HOST + path, data=json.dumps(body).encode() if body is not None else None,
                                 headers={"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req, timeout=30))

wf = json.load(open("moss_api.json"))
wf["4"]["inputs"]["text"] = "A rainy night in a narrow city alley lit by pink and blue neon, ..."  # positive prompt
wf["6"]["inputs"].update(width=928, height=2016)                       # multiples of 16
wf["7"]["inputs"].update(seed=random.randint(1, 2**50), steps=25)      # keep sampler_name = euler
wf["9"]["inputs"]["filename_prefix"] = "moss_demo"

pid = call("/prompt", {"prompt": wf, "client_id": "demo"})["prompt_id"]
while pid not in (hist := call("/history")):
    time.sleep(10)
print(hist[pid]["status"]["status_str"], [i["filename"] for o in hist[pid]["outputs"].values() for i in o.get("images", [])])
A rainy night in a narrow city alley lit by pink and blue neon, a glowing neon sign on the lower half of the wall with the words OPEN LATE, wet asphalt reflecting the colourful lights, steam rising from a small vent, a few puddles, cinematic and moody, ultra detailed, the upper third a calm dark night sky between the buildings.